- SkillEvaluator är ett ramverk med öppen källkod som använder ett system i tre nivåer för att validera säkerheten, originaliteten och den verkliga effekten av färdigheter hos AI-agenter.
- Implementering av verifierade färdigheter ökar agenternas noggrannhet och effektivitet dramatiskt, vilket ger förbättringar på upp till 41 poäng i uppgiftskorrigering.
- Utvärderingsprocessen använder Harbor för att köra A/B-tester i isolerade miljöer och jämför agentens prestanda med och utan den installerade färdigheten.
Du har förmodligen upplevt detta: du bygger en AI-agent med de bästa modellerna på marknaden och oklanderlig dokumentation, men saken fortsätter att gå runt i cirklar, slösa tokens som galningar eller gå vilse på stigar som inte leder någonstans. Problemet är vanligtvis inte modellens kraft, utan sammanhanget. För att lösa detta huvudvärk har NVIDIA släppt SkillEvaluator, ett verktyg med öppen källkod som är specifikt utformat för att testa de funktioner eller "färdigheter" vi lägger till i dessa agenter och se om de faktiskt bidrar med något eller bara är hype.
I grund och botten är färdigheter som optimerade instruktionsmanualer och signerade paket som berättar för agenten vad en NVIDIA-produkt gör, när det är rätt tid att använda den och exakt hur den ska namnges. SkillEvaluator fungerar som den domare som avgör om en färdighet är redo för produktion, och jämför agentens prestanda i verkliga situationer med hjälp av ett system med rigorösa standarder och A/B-testning i kontrollerade miljöer, vilket förhindrar agenten från att improvisera baserat på felaktiga antaganden.
Tre-nivå filtreringssystem
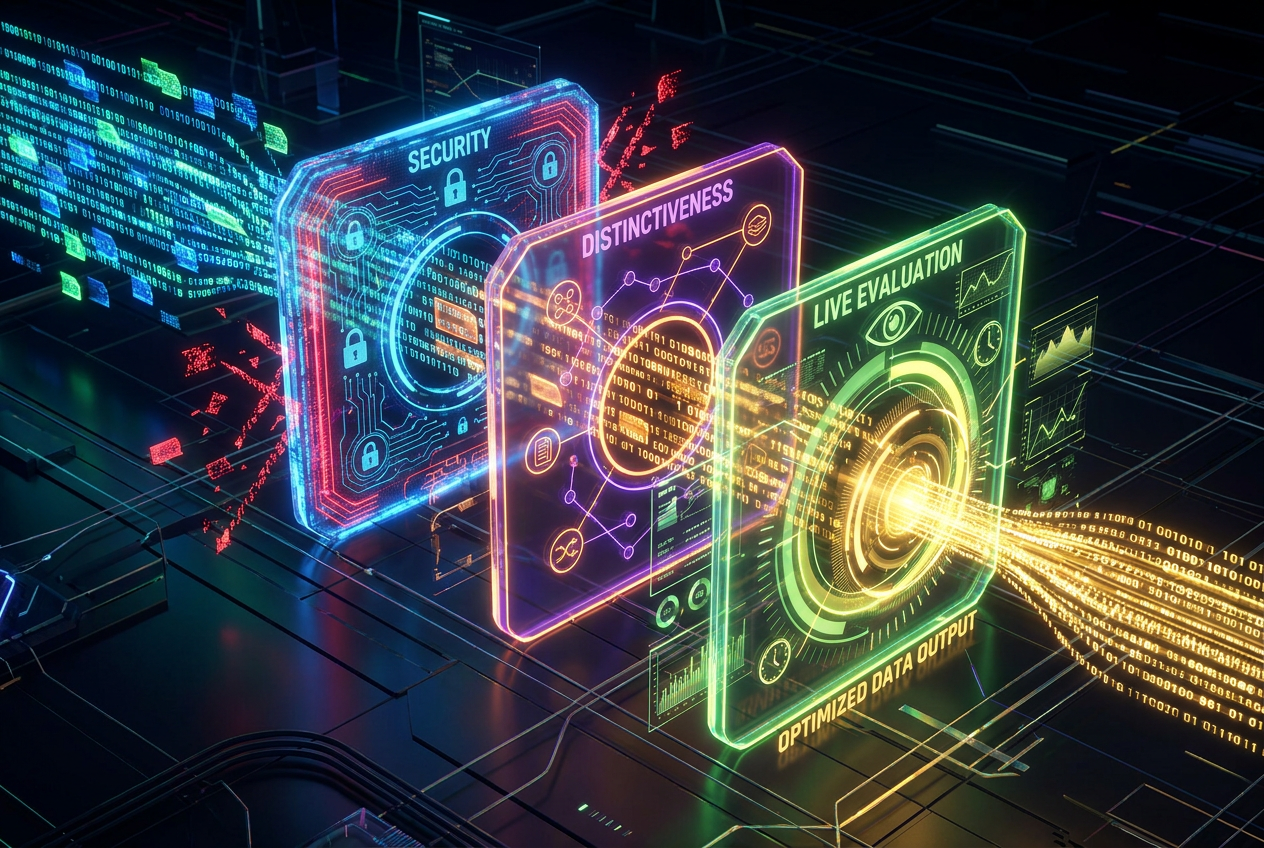
För att en färdighet ska anses vara "verifierad" måste den gå igenom en process i tre steg. Den goda nyheten är att du inte behöver slutföra dem i ordning; du kan hoppa direkt till den du behöver beroende på vilket problem du vill lösa.
- Nivå 1: Säkerhet och struktur. Det är här den grundliga städningen sker. Systemet kontrolleras för riktighet, avslöjade hemligheter och personlig information (PII) söks efter och eventuella risker analyseras. snabba injektionsattacker eller dataexfiltrering. Det är här det kommer in i bilden SkillSpector, en specialiserad skanner som söker efter fler än 68 sårbarhetsmönster, från triggermissbruk till minnesförgiftning.
- Nivå 2: Särskiljningsförmåga och överlappning. Det är meningslöst att ha tio färdigheter som alla säger samma sak. Den här nivån använder likhet mellan inbäddningar för att upptäcka om en färdighet upprepar instruktioner som redan finns i katalogen eller om den överlappar för mycket med andra, och därmed optimera agentens kontextutrymme.
- Nivå 3: Livebedömning. Detta är det ultimata testet. Här används verkliga, syntetiskt genererade uppgifter som körs i isolerade sandlådor med hjälp av Harbor, ett ramverk med öppen källkod. Samma uppgift körs två gånger: en gång med färdigheten och en gång utan den, och mäter exakt hur mycket resultatet har förbättrats.
Framgångsmått och Skill Lift-konceptet
När NVIDIA testade över 300 färdigheter i fler än 30 produkter var informationen avslöjande. Det viktigaste måttet är Skill Lift , vilket helt enkelt är skillnaden i poäng mellan utförande med och utan färdigheten. Resultaten visar att medan agenter utan färdigheten presterade inom ett mediokert intervall på 39 till 46 poäng, resulterade installationen av de verifierade färdigheterna i ett dramatiskt språng i prestanda.
När det gäller noggrannhet och korrekthet steg den genomsnittliga poängen från 46 till 87 poäng, en förbättring med 41 poäng. Effektiviteten ökade från 39 till 78, och agentens förmåga att hitta rätt verktyg steg från 42 till 82. Effektiviteten hoppade från 43 till 78. Intressant nog hade säkerheten redan en mycket hög baslinje (97 poäng), så förbättringen var minimal och steg till 98, vilket visar att säkerhet har varit en prioritet sedan den ursprungliga designen.
Den hårda verkligheten med tokens och prestanda
Det är inte bara solsken och regnbågar; det finns en detalj som ibland förbises: färdigheter sparar inte alltid pengar. NVIDIA har varit väldigt ärliga och erkänt att tokenbesparingar inte är garanterade . Det beror helt på färdigheten och hur optimerad den är. Till exempel lyckades en minnesoptimeringsfärdighet i Jetson minska tokens med 76,9 % och exekveringstiden med 53,7 %, vilket är fantastiskt.
Motsatsen skedde dock med installationsfärdigheten cuOpt, vilket ökade tokenanvändningen med 120,3 % och ökade exekveringstiden. Det är just detta som gör SkillEvaluator värdefull: den låter dig upptäcka vilka färdigheter som hjälper agenten att bli smartare, men på bekostnad av att API-kostnaden ökar , vilket gör det möjligt för utvecklare att justera koden innan den når slutanvändaren.
Implementación técnica y flujo de trabajo
För de som vill smutsa ner händerna är processen ganska enkel. Det rekommenderas att använda uv för installation. När den är konfigurerad kan en utvärderingsdatauppsättning genereras med kommandot create-eval-dataset, vilket skapar explicita, implicita och till och med negativa fall för att försöka lura agenten.
Därefter startas nivå 3-bedömningen med kommandot tier3 evaluateSystemet konverterar dessa ärenden till uppgiftspaket för Harbor, kör dem i Hamnarcontainrar eller molnmiljöer, och utfärdar en detaljerad rapport i format som JSON, HTML eller Markdown. Det är viktigt att nämna att språkmodell som används Det spelar roll, även om data tyder på att produktbehärskning och kvaliteten på bedömningsuppsättningen spelar mycket större roll än om du använder Claude Code eller Kodeks.
Detta ekosystem används redan av partners som OpenClaw i ClawHub och Nous Research i Hermes Agent, och integrerar SkillSpector-skanning för att säkerställa att inga farliga färdigheter installeras. I slutändan har NVIDIA levererat ett sätt att standardisera A/B-testning för artificiell intelligens, vilket eliminerar gissningar och baserar agentförbättringar på matematiska data och isolerade tester som garanterar att varje tillagd kunskap verkligen höjer prestandanålen.